Tutorial prático do Kraken2 + Bracken (Conda)
Quem está na sua amostra? Classificação taxonômica com Kraken2, Bracken e Krona
Fala, pessoal! Bora falar do
Kraken2
Classificador taxonômico de reads baseado em k-mers, muito usado em metagenômica shotgun.
?
Esse é o queridinho da casa (não é à toa que meu Medium se chama Krakenomics 😅).
Depois que você limpou os seus FASTQs, a pergunta que todo mundo quer responder é:
quem está na festa? Quais bactérias, fungos e vírus estão na sua amostra, e em que proporção?
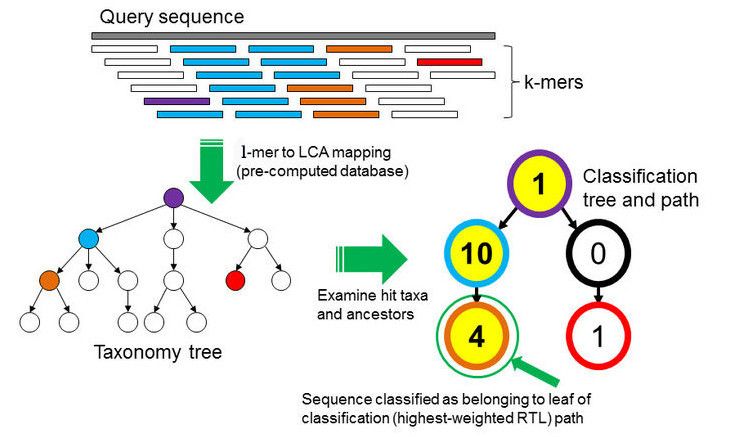
O Kraken2 responde isso de um jeito muito rápido. Ele quebra cada read em pedacinhos chamados
k-mers
Subsequências de tamanho k (ex.: 35 bases) extraídas de uma sequência maior.
,
procura esses pedacinhos em um
banco de dados
Índice construído a partir de genomas de referência (RefSeq) com a taxonomia do NCBI.
e, quando um k-mer aparece em vários organismos, ele usa o
LCA
Lowest Common Ancestor: o ancestral comum mais baixo na árvore taxonômica entre os organismos que compartilham aquele k-mer.
para decidir onde classificar a read.
Só que o Kraken2 sozinho tem um porém: muitas reads ficam "presas" em níveis mais altos (gênero, família), porque o k-mer é compartilhado por várias espécies. Aí entra o Bracken Bayesian Reestimation of Abundance with KrakEN: redistribui as reads para o nível de espécie e estima a abundância. , que redistribui essas reads e estima a abundância de cada espécie. E pra fechar com chave de ouro, o Krona transforma tudo num gráfico interativo lindo em HTML.
Ainda está confuso com metagenômica, metataxonomia e metabarcoding? Escrevi sobre isso no Medium: Quem está na festa? e O que existe aqui?.
O que você vai precisar antes:
- Conda — instalação aqui
- WSL/Linux — tutorial aqui
- FASTQs limpos — de preferência depois do trimming. Se ainda não fez, siga o guia do Fastp (é exatamente de onde este guia continua)
- Memória e espaço em disco — uns 8 GB de RAM livres e ~15 GB de disco para o banco de dados
Neste guia, você vai:
- Criar um ambiente Conda com Kraken2, Bracken, KrakenTools e Krona,
- Baixar um banco de dados pronto (sem precisar construir nada!),
- Classificar as reads, entender o relatório e estimar a abundância por espécie,
- Gerar um gráfico interativo e rodar tudo para várias amostras de uma vez.

Passo a passo
- Preparação do ambiente
- Baixando o banco de dados
- Classificando as reads com Kraken2
- Entendendo o relatório (kreport)
- Estimando a abundância com Bracken
- Visualizando com Krona
- Rodando várias amostras de uma vez
1. Preparação do ambiente
Crie um ambiente com tudo que a gente vai usar:
conda create -n kraken2 -c bioconda -c conda-forge kraken2 bracken krakentools krona -y
conda activate kraken2
kraken2 é o nome do ambiente. Dentro dele você terá:
•kraken2— a classificação em si,
•bracken— a reestimativa de abundância,
•krakentools— scripts úteis (a gente vai usar okreport2krona.py),
•krona— os gráficos interativos (ktImportText).
Confirme se está tudo funcionando:
kraken2 --version
bracken -v
2. Baixando o banco de dados
O Kraken2 precisa de um banco de dados. Você até pode construir o seu, mas isso leva horas e precisa de muita memória. A boa notícia é que o pessoal do Ben Langmead disponibiliza bancos prontos e atualizados. Para começar, o melhor custo-benefício é o Standard-8 Banco "Standard" (arqueias, bactérias, vírus, plasmídeos, humano e UniVec_Core) limitado a 8 GB. , que cabe em computadores comuns.
| Banco | Download | Tamanho final | Quando usar |
|---|---|---|---|
Standard-8 |
5,5 GB | 7,5 GB | Notebook/WSL, aulas, primeiros testes. |
Standard-16 |
11,2 GB | 14,9 GB | Mais sensibilidade, se você tiver ~16 GB de RAM. |
PlusPF-8 |
— | ~8 GB | Quando você também quer protozoários e fungos. |
Crie uma pasta para guardar os bancos (fora da pasta do projeto, assim você reaproveita em outras análises) e baixe o Standard-8:
mkdir -p ~/bases/kraken2/k2_standard_08
cd ~/bases/kraken2

wget https://genome-idx.s3.amazonaws.com/kraken/k2_standard_08_GB_20260626.tar.gz
tar -xvzf k2_standard_08_GB_20260626.tar.gz -C k2_standard_08
rm k2_standard_08_GB_20260626.tar.gz
A data no nome do arquivo (20260626) é a versão do banco. Eles atualizam algumas vezes por ano:
confira a versão mais nova na página dos índices
e troque a data no comando.
Confira se os arquivos principais estão lá:
ls ~/bases/kraken2/k2_standard_08
Você deve ver pelo menos hash.k2d, opts.k2d e taxo.k2d (esses são o banco do Kraken2) e
vários arquivos database*mers.kmer_distrib (esses são do Bracken, guarda essa informação aí!).
Para não ter que digitar o caminho toda hora, salve numa variável:
export K2DB=~/bases/kraken2/k2_standard_08
Está no WSL? Por padrão ele usa só metade da RAM do Windows. Se o Kraken2 for "morto" sem explicação (Killed), aumente a memória do WSL criando o arquivoC:\Users\SEU_USUARIO\.wslconfigcom:[wsl2] memory=10GBDepois rodewsl --shutdownno PowerShell e abra o terminal de novo.
3. Classificando as reads com Kraken2
Volte para a pasta do projeto que a gente montou no guia do Fastp e crie uma pasta para os resultados:
cd ~/analise_dados/aula_1
mkdir -p kraken2
Não fez o guia do Fastp? Sem problema! Use seus próprios FASTQs ou baixe dados públicos com o SRA-Tools. Só troque os nomes dos arquivos nos comandos abaixo.
Agora rode o Kraken2 nas reads limpas (paired-end):
kraken2 \
  --db $K2DB \
  --threads 4 \
  --paired \
  --gzip-compressed \
  --confidence 0.1 \
  --report kraken2/meta_aula_1.kreport \
  --output kraken2/meta_aula_1.kraken \
  pos_trim/meta_aula_trim_1_L001_R1_001.fastq.gz \
  pos_trim/meta_aula_trim_1_L001_R2_001.fastq.gz
Principais parâmetros:
| Parâmetro | Descrição |
|---|---|
--db |
Pasta do banco de dados (a variável $K2DB). |
--threads 4 |
Número de núcleos do processador usados. |
--paired |
Avisa que são dois arquivos (R1 e R2) do mesmo fragmento. |
--gzip-compressed |
Os FASTQs estão compactados (.gz). |
--confidence 0.1 |
Exige que pelo menos 10% dos k-mers concordem com a classificação. Reduz falsos positivos (o padrão é 0). |
--report |
Relatório resumido por táxon (o arquivo mais importante!). |
--output |
Classificação de cada read, uma por linha (pode ficar grande). |
No final, o Kraken2 mostra um resumo parecido com este:
Loading database information... done.
123456 sequences (61.73 Mbp) processed in 4.512s (1642.0 Kseq/m, 820.81 Mbp/m).
  98765 sequences classified (80.00%)
  24691 sequences unclassified (20.00%)
Computador com pouca RAM? Adicione --memory-mapping. O Kraken2 passa a ler o banco direto do disco em vez de
carregar tudo na memória. Fica mais lento, mas funciona.
Se você não vai usar a classificação read a read, pode economizar espaço com--output /dev/null. O--reporté o que a gente usa daqui pra frente.
4. Entendendo o relatório (kreport)
O arquivo .kreport é uma tabela com seis colunas:
| Coluna | O que significa |
|---|---|
| 1 | % das reads naquele táxon e em tudo abaixo dele (clado). |
| 2 | Número de reads no clado. |
| 3 | Número de reads atribuídas diretamente àquele táxon. |
| 4 | Nível taxonômico: U (não classificado), D (domínio), P, C, O, F, G, S (espécie)… |
| 5 | TaxID do NCBI. |
| 6 | Nome científico (a indentação mostra a hierarquia). |
Quer ver as 10 espécies com mais reads? Rode:
awk -F'\t' '$4=="S"' kraken2/meta_aula_1.kreport | sort -t$'\t' -k2,2nr | head -10
Cuidado com espécies que aparecem com pouquíssimas reads (tipo 1 a 10). Elas podem ser falsos positivos Classificações erradas causadas por k-mers compartilhados, contaminação ou limitações do banco. . Antes de sair escrevendo no artigo que achou um patógeno raro, confira com outra ferramenta (ex.: MetaPhlAn).
5. Estimando a abundância com Bracken
Lembra dos arquivos database*mers.kmer_distrib que vieram com o banco? O número no nome é o
tamanho de read para o qual aquele arquivo foi calculado. Escolha o mais próximo do tamanho das suas reads:
ls $K2DB/*kmer_distrib
Agora rode o Bracken no nível de espécie:
bracken \
  -d $K2DB \
  -i kraken2/meta_aula_1.kreport \
  -o kraken2/meta_aula_1.bracken \
  -w kraken2/meta_aula_1_bracken.kreport \
  -r 150 \
  -l S \
  -t 10
Principais parâmetros:
| Parâmetro | Descrição |
|---|---|
-i |
O .kreport gerado pelo Kraken2. |
-o |
Tabela de abundância (uma linha por espécie). |
-w |
Um novo kreport, já com as reads redistribuídas (a gente usa no Krona). |
-r 150 |
Tamanho das reads (tem que existir o database150mers.kmer_distrib). |
-l S |
Nível taxonômico: S espécie, G gênero, F família… |
-t 10 |
Ignora táxons com menos de 10 reads (ajuda a cortar ruído). |
Abra a tabela e ordene pela abundância (última coluna, fraction_total_reads):
sort -t$'\t' -k7,7gr kraken2/meta_aula_1.bracken | head -10 | column -t -s$'\t'
Não sabe o tamanho das suas reads? Olhe o relatório do Fastp ou do FastQC (Sequence length), ou rode:
zcat pos_trim/meta_aula_trim_1_L001_R1_001.fastq.gz | head -400 | awk 'NR%4==2{print length($0)}' | sort -n | uniq -c | tail -3
6. Visualizando com Krona
Agora a parte bonita! Converta o kreport do Bracken para o formato do Krona e gere o HTML:
kreport2krona.py -r kraken2/meta_aula_1_bracken.kreport -o kraken2/meta_aula_1.krona.txt
ktImportText kraken2/meta_aula_1.krona.txt -o kraken2/meta_aula_1.krona.html
Abra ometa_aula_1.krona.htmlno navegador. Dá pra clicar em cada fatia e ir descendo de filo até espécie. No Windows, ache o arquivo pelo File Explorer → Linux, seguindo o caminho mostrado pelopwd(igual fizemos no guia do FastQC).
7. Rodando várias amostras de uma vez
Na vida real você não tem uma amostra só, né? Use um loop para rodar tudo de uma vez.
Esse exemplo pega todos os R1 da pasta pos_trim/ e descobre o R2 sozinho:
for r1 in pos_trim/*_R1_001.fastq.gz; do
  r2=${r1/_R1_/_R2_}
  amostra=$(basename "$r1" _R1_001.fastq.gz)

  kraken2 --db $K2DB --threads 4 --paired --gzip-compressed --confidence 0.1 \
    --report kraken2/${amostra}.kreport --output /dev/null "$r1" "$r2"

  bracken -d $K2DB -i kraken2/${amostra}.kreport -o kraken2/${amostra}.bracken \
    -w kraken2/${amostra}_bracken.kreport -r 150 -l S -t 10
done
E depois junte tudo numa tabela só, com uma coluna por amostra:
combine_bracken_outputs.py --files kraken2/*.bracken -o kraken2/abundancia_todas.tsv
O Krona também aceita várias amostras de uma vez, e cada uma vira uma "aba" no mesmo HTML:ktImportText kraken2/*.krona.txt -o kraken2/todas.krona.html(rode okreport2krona.pypara cada amostra antes).
Conclusão
Você montou um fluxo completo de classificação taxonômica para metagenômica shotgun:
- Classificação das reads com Kraken2
- Reestimativa de abundância por espécie com Bracken
- Visualização interativa com Krona
- Tudo em loop, para quantas amostras você quiser
Com a tabela abundancia_todas.tsv em mãos, dá pra partir para o R ou Python e calcular diversidade alfa e beta, fazer gráficos de barras empilhadas e comparar grupos.
Até a próxima!

Desafio!!!
Sabia que o MultiQC também lê os relatórios do Kraken2?
Rode multiqc . na pasta do projeto e veja o Fastp, o Falco e o Kraken2 no mesmo relatório.
E se você colocar tudo isso dentro de um Snakefile ou de um
pipeline Nextflow? Do FASTQ bruto ao Krona com um comando só!
Até a próxima!
Dê um suporte ao meu projeto. Doe um cafézinho ☕.
Pix: biologolee@gmail.com
Bitcoin: bc1qg7qrfhclzt3sm60en53qv8fmwpuacfaxt5v55k
Referências
- Kraken2 — repositório oficial
- Manual do Kraken2
- Improved metagenomic analysis with Kraken 2 (Genome Biology, 2019)
- Bancos pré-construídos do Kraken2/Bracken
- Bracken — repositório oficial
- Bracken: estimating species abundance in metagenomics data (PeerJ Computer Science, 2017)
- KrakenTools
- Krona — repositório oficial
- Metagenome analysis using the Kraken software suite (Nature Protocols, 2022)